Van Kwast naar Kleurenscherm: hoe Japanse tekst op de computer verscheen
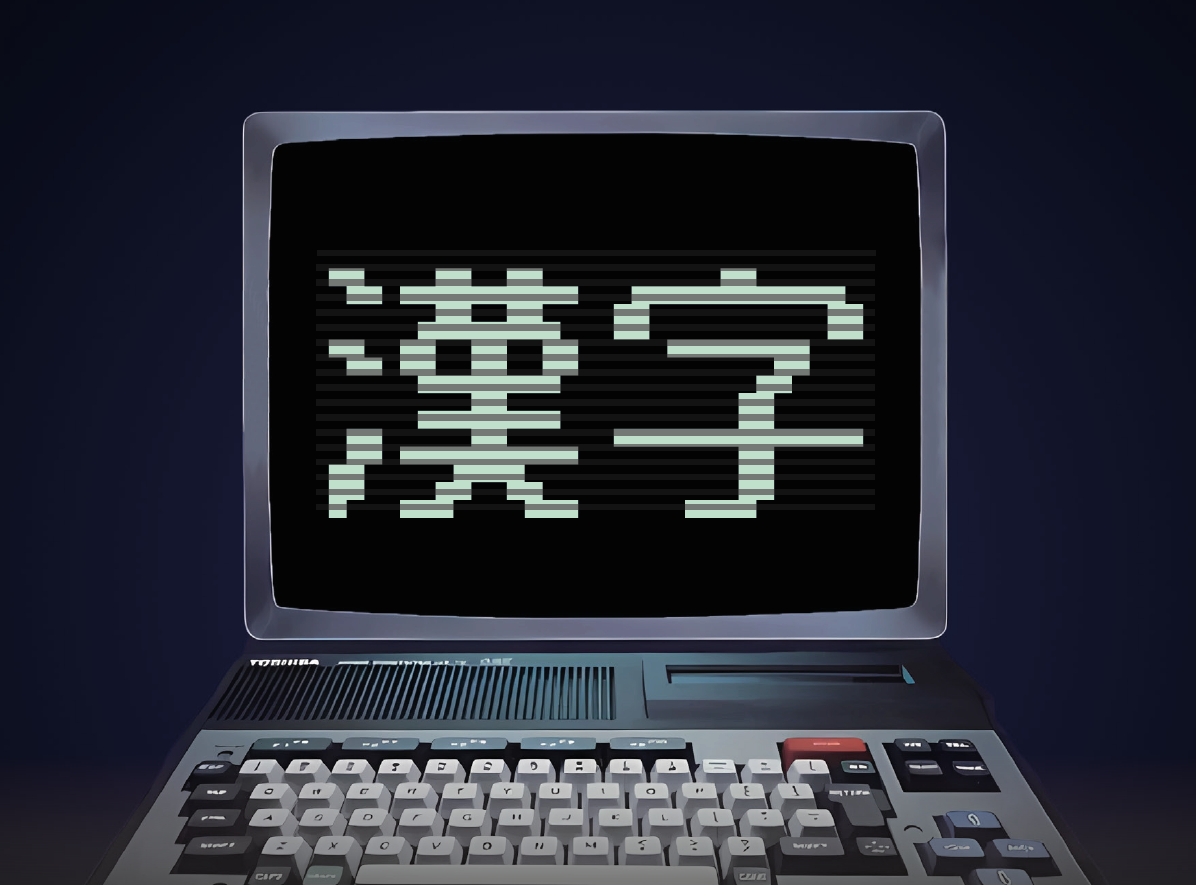
Het volgende artikel is misschien niet wat je in de TaTanukiKi zou verwachten. Ook lijkt het op het eerste gezicht niet een onderwerp waar veel over te vertellen is. Bij het maken van je huiswerk, het nemen van aantekeningen of het duizendste maal opzoeken van hetzelfde woord op Jisho denk je er waarschijnlijk niet over na hoe het kan dat computers klaarblijkelijk feilloos Japanse karakters kunnen weergeven. Hoewel dit tegenwoordig ook zeker relatief eenvoudig is voor computers, was dit in het verleden zeker niet zo en is hier veel werk aan vooraf gegaan. Naast dat er afspraken moesten worden gemaakt over hoe ondersteuning van het schrift daadwerkelijk geïmplementeerd moest worden en ervoor gezorgd moest worden dat computer- en software-ontwikkelaars zich hieraan hielden, waren er bij oudere computers ook veel technische limitaties die dit proces in de weg zaten. Daarom neem ik, een deeltijd hobby-computerarcheoloog, je mee op een tijdreis die de eeuwenoude kanji hebben afgelegd om op jouw schermpje te verschijnen.
Ik ga ervan uit dat jij als lezer enige basiskennis hebt van het Japanse schrift. Toch zal ik nog even wat eigenschappen van het schrift aanstippen, om zo de complexiteit van het vraagstuk waar wij ons mee bezig gaan houden te illustreren en te laten zien waarom dit verschilt van het digitaliseren van ons eigen alfabet. Het Latijnse alfabet kent, afhankelijk van de lokale variant die gebruikt wordt, ongeveer 25 tot 30 karakters, varianten van deze karakters met diakritische tekens en nog een set leestekens en andere symbolen die in normale teksten voorkomen. Dit staat in schril contrast tot de 2 lettergreepschriften en de kanji die in het Japans gebruikt worden. Waar het dus voor het ondersteunen van Latijns schrift om niet meer dan 200 karakters gaat—afhankelijk van of hoofdletters en kleine letters apart worden gerepresenteerd—is dat bij Japans schrift al gauw vele duizenden.
In dit artikel zal je geregeld de term encoding zien langskomen, en deze zal je misschien al wel een keer eerder gezien hebben (bijvoorbeeld in de context van digitale beelden of geluiden), maar voor de leesbaarheid van dit artikel zal ik er nog een duidelijke definitie voor geven. Hoewel encoding heel breed begrepen kan worden, is de basisbetekenis heel simpel: een encoding wordt gebruikt om bepaalde informatie te representeren op een manier die ondersteund wordt door het medium of systeem waarop het gebruikt wordt. Dit klinkt misschien wat vaag, maar in het geval van Japanse tekst betekent dit dus dat door middel van encoding tekst kan worden opgeslagen en weergegeven op, en verstuurd worden tussen computers.
Voordat we echt kunnen duiken in de ontwikkelingen rond het ondersteunen van Japans schrift op de computer, is het nuttig eerst te kijken naar andere toepassingen waar een zogenaamde encoding nodig was. Computers waren hierin namelijk niet de eerste, want al ver voor hun introductie was er bijvoorbeeld voor communicatie op lange afstand een manier nodig om Japanse tekst over te brengen. Een mooi voorbeeld hiervan is de zogenaamde Wabun-code (和文モールス符号). Dit is vergelijkbaar met het Westerse Morse-systeem, waarbij met behulp van korte en lange piepjes tekst via een telegraaf- of radioverbinding overgebracht kon worden. Hoewel er meerdere van deze systemen in Japan hebben bestaan, is een vroege—doch niet al te veel gebruikte—versie van dit systeem volgens sommige bronnen door een Nederlander geïntroduceerd. Over de details van dit systeem is helaas niet veel in openbare bronnen te vinden. Het systeem dat uiteindelijk veelvuldig gebruikt is probeerde Japanse tekst niet op basis van de oorspronkelijke karakters, maar op basis van uitspraak te encoderen. Hiermee kreeg het een vergelijkbare indeling als de twee kana-systemen, maar dan met voor ieder karakter een reeks punten en streepjes, of korte en lange tonen als het elektronisch verstuurd werd. Ter illustratie, het woord 私 zou als volgt worden geëncodeerd:
▄▄▄ ▄ ▄▄▄ ▄▄▄ ▄ ▄▄▄ ▄▄▄ ▄ ▄▄▄ ▄
わ た し
wa ta shi
Zoals je misschien al wel eens hebt gehoord zijn computers eigenlijk ontstaan als uit de kluiten gewassen rekenmachines. Een resultaat van deze oorsprong is dus dat computers in de basis nog steeds apparaten zijn die werken met getallen. Tegenwoordig kun je natuurlijk veel meer met computers dan 1+1 berekenen, maar ook bij deze complexere toepassingen vinden er op de achtergrond nog steeds vrij basale numerieke berekeningen plaats. Dit betekent dus dat iets als tekst, of specifieker nog karakters, als nummer gerepresenteerd moeten worden. Voor ieder karakter is er dus, om het nog even simpel te houden, een eigen nummer nodig. Om weer even terug te gaan naar het eerder genoemde voorbeeld van het Latijnse schrift, hier zouden de verschillende karakters ieder met een getal tussen de 1 en 200 kunnen worden gerepresenteerd. Als in dit voorbeeld de letters a t/m z aan de getallen 1 t/m 26 worden gekoppeld, zou de tekst “tanuki” er in een hypothetische computer intern uit zien als:
[20,1,14,21,11,9].
Binnen het geheugen en andere componenten van computers kan niet zomaar met arbitrair grote getallen gewerkt worden, en om deze componenten dus minder complex te maken wordt met een veelvoud van een aantal bits (eenen en nullen) gewerkt. Dit veelvoud is vaak 8, en omdat deze veel gebruikt wordt, heeft deze zijn eigen naam—byte—gekregen. Deze byte is zowel in hardware als in software—en dus ook in digitale communicatie—al lange tijd een fundamentele bouwsteen. Omdat er in één byte 8 bits zitten, is het aantal verschillende waardes dat hiermee gerepresenteerd kan worden 28, ofwel 256. Dit zou dus voldoende moeten zijn voor het Latijnse schrift, maar zeker niet genoeg voor alle karakters die in het Japans gebruikt worden. Hierin zit dan ook het grootste probleem waar informatici in Japan en daarbuiten decennialang aan gewerkt hebben.
Dan zijn we nu aangekomen bij het begin van de geschiedenis van Japanse tekst op computers. Uit de doorontwikkeling van telegraafmachines was in het Taishō-tijdperk was een nationale standaard gekomen voor het versturen van tekst, maar deze was te gelimiteerd voor het gebruik in geavanceerde digitale systemen. Hierom vormde de Information Processing Society of Japan (情報処理学会) in het begin van de jaren 60 een commissie die een geschikte encoding moest samenstellen. Zoals dat vaak gaat bij op de achtergrond opererende groepjes is er niet veel te vinden over hoe dit proces verliep (in ieder geval niet in openbare bronnen), maar gezien het eindresultaat waren een aantal zaken duidelijk. Omdat computers nog relatief simpel waren, konden karakters enkel uit 7 of 8 bits bestaan. Daarnaast werd er waarde gehecht aan de uitwisseling van gegevens met internationale partijen.
Dit eerste betekende dat ondersteuning van alle Japanse karakters nog niet mogelijk was. Er moest dus net als bij de Wabun-code een compromis gevonden worden. Daarom werd ervoor gekozen alleen de katakana-karakters in dit systeem op te nemen. De keuze voor een van de kana-systemen lijkt voor de hand liggend, omdat hiermee met een sterk gereduceerd aantal karakters toch de taal kon worden uitgeschreven. Je vraagt je dan misschien wel af waarom er voor katakana en niet voor hiragana is gekozen. Hoewel ik hier niet een concreet antwoord op kon verzinnen, en ik vermoed dat er ook historische redenen voor zijn—bijvoorbeeld uit de tijd van de telegraafmachines—hebben deze karakters op computers van die tijd een groot voordeel: door hun simpelere uiterlijk zijn ze duidelijker weer te geven op de hardware van die tijd. Het is ook nog interessant om hierbij te vermelden dat—hoewel dit strikt genomen niet met de encoding te maken heeft—deze katakana-karakters in halve breedte werden weergegeven. Dit werd gedaan zodat deze evenveel ruimte zouden innemen als de andere symbolen (Latijnse tekens enz.).
Om de uitwisseling van gegevens met niet-Japanse systemen mogelijk te maken, baseerde de commissie een deel van hun systeem op het internationaal gebruikte ASCII (American Standard Code for Information Interchange). Hierdoor kon met dit systeem zowel Japanse als Westerse tekst weergegeven worden. Wel werden er kleine aanpassingen gedaan aan de standaardindeling van ASCII. Dit had een paar opmerkelijke gevolgen. Zo werd de \ vervangen door het ¥-symbool, wat ervoor zorgde dat in latere besturingssystemen zoals MS-DOS het bekende prompt er niet zo uit zag:
C:\mapje1\mapje1>
maar zo:
C:¥mapje1¥mapje1>
Dit systeem werkte goed, maar er bleef toch de wens voor een systeem dat ook kanji zou ondersteunen. Omdat Japan, in tegenstelling tot de omringende landen zoals China en Korea, al vroeg meedeed in de ontwikkeling en productie van computers en zij ten tijde van de popularisatie van computers bij gewone mensen thuis een specifieke groep computers voor de eigen markt hadden probeerden veel bedrijven afzonderlijk een oplossing voor dit probleem te vinden. Individuele fabrikanten en ontwikkelaars van software probeerden ervoor te zorgen dat gebruikers bijvoorbeeld in tekstverwerkingsprogramma’s in kanji konden schrijven. Uiteindelijk kwam het zover dat er aan het einde van de jaren 70 een revisie kwam op de oudere standaard. In deze standaard zou ieder karakter niet met 1, maar met 2 bytes opgeslagen worden. Dit betekende een theoretisch bereik van 65.536, in plaats van 256 bij het oudere systeem. Deze nieuwe ruimte werd niet volledig gebruikt; uiteindelijk zouden er 6879 karakters in opgenomen worden. Desalniettemin betekende het een enorme verbetering ten opzichte van het systeem met enkel kana, en maakte het de weg vrij voor daadwerkelijk kanji-gebruik op computers.
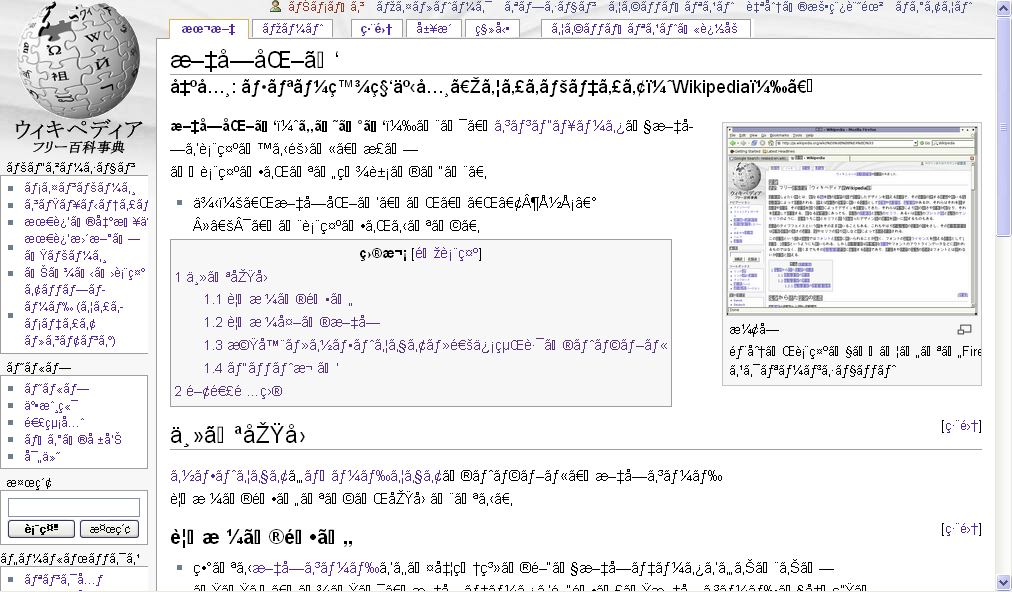
Hoewel dit nieuwe systeem aan veel van de eisen zou voldoen, gooide de introductie en het toenemende gebruik van het internet in Japan en elders roet in het eten. Al zou een Japanse website er op een Japanse computer prima uitzien, werd deze wanneer bekeken op een computer in het Westen een soep van onsamenhangende karakters. Dit fenomeen zou bekend komen te staan als Mojibake (文字化け). Dit was een resultaat van het feit dat de getallen waarmee kanji in het Japanse systeem gerepresenteerd werden aan een ander getal gekoppeld waren in het Westerse systeem. Een Westerse webbrowser probeert dus braaf de tekst weer te geven, niet wetende dat er niks samenhangends uit komt.
Mede hierom is er sinds het einde van de jaren 80 gewerkt aan een universeel encoding-systeem waarin alle karakters van alle talen zijn opgenomen. Dit systeem heet Unicode, en wordt tegenwoordig door vrijwel ieder modern stuk software en ook de meeste websites gebruikt. Hoewel het misschien onmogelijk klinkt om ieder karakter in één zo’n systeem te gieten, lijkt dat met 149,186 karakters in de meest recente versie aardig te lukken. Ook in dit systeem moeten de karakters weer gekoppeld worden aan een specifiek getal, maar omdat computers tegenwoordig een stuk geavanceerder zijn hoeft dit niet meer in een vast aantal bits, bijvoorbeeld 8 of 16, maar kan dit variëren van 1 tot 3 bytes afhankelijk van hoe hoog het desbetreffende getal is. Op deze manier kunnen alle kana en kanji—zelfs minder gebruikte karakters, of zelfs verschillende varianten—met behulp van dit ene systeem vrijwel universeel gebruikt worden.
Ter afsluiting dan nog een paar opmerkingen. Het is algemeen bekend dat men in Japan soms een beetje te lang gebruik blijft maken van verouderde technologieën. Het nog steeds wijdverspreide gebruik van fax-apparaten is hier een mooi voorbeeld van. Ook in het geval van deze encoding-systemen is dit gebeurd/gebeurt dit mogelijk nog steeds. Het simpele systeem uit de jaren 60 werd nog tot 2018 (in deels gewijzigde vorm) gebruikt door het Nationwide Banking Data Communication System (全国銀行データ通信システム) dat gebruikt werd voor het uitwisselen van banktransacties tussen verschillende banken in Japan. Een ander verhaal dat verwant is aan deze ontwikkelingen—maar waar ik nu niet verder in zal duiken—is dat van de emoji. Het was immers de stap van de losse encoding-systemen in Japan naar het Unicode-systeem dat deze symbolen in het Westen zou introduceren.